NAS Gitea 크롤링 공격 대웅
NAS(시놀로지)가 어느날 먹통이 되었다.
HDD가 드르륵 거리며 몇 시간 동안 계속 리소스를 많이 먹으면서 DSM 자체가 동작을 할 수 없을 정도였다.
처음엔 데이터 스크러빙을 수행한 줄 알았으나,
데이터 스크러빙을 설정한 기록이 없었다.
NAS를 사용해야하는 상황에 급하게 전원 버튼으로 강재 재부팅을 시도했다.
재부팅 후에는 이전처럼 다시 정상 동작하였다.
무엇이 문제였을까?
제미나이에게 질문하며 몇가지 점검을 진행하였다.
예약된 스크러빙이 아님에도 이런 현상이 발생하는 대표적인 원인들을 정리해 드립니다.

1. 인덱싱(Indexing) 작업의 폭주
가장 흔한 원인입니다. Synology Photos, Video Station, 혹은 Universal Search가 새로운 파일이나 변경된 데이터를 감지하면 파일의 메타데이터를 추출하고 썸네일을 생성합니다.

증상: CPU 점유율은 낮아도 디스크 사용률(I/O Wait)이 100%에 도달하며 시스템이 응답하지 않음.

체크: [제어판] > [색인 서비스]에서 작업 상태를 확인해 보세요.

2. 메모리 부족으로 인한 '스왑(Swap)' 현상
NAS의 RAM이 가득 차면 시스템은 하드디스크의 일부 공간을 메모리처럼 사용하기 시작합니다(Swap). 하드디스크는 RAM보다 수만 배 느리기 때문에, 데이터를 읽고 쓰는 과정에서 '드르륵' 소리가 심해지고 시스템이 사실상 멈춰버립니다.

원인: 특정 패키지(Docker, 가상 머신 등)의 메모리 누수나 과다 점유.

로그에 안 남는 이유: 커널 수준에서 멈추기 때문에 일반적인 사용자 로그에는 기록되지 않는 경우가 많습니다.

3. Btrfs 파일 시스템의 자가 복구 또는 조각 모음
Btrfs 파일 시스템을 사용 중이라면, 시스템이 백그라운드에서 파일 체크섬을 대조하거나 메타데이터를 정리하는 작업을 수행할 수 있습니다.

데이터 쓰기가 빈번한 환경(다운로드 스테이션 등)에서는 파일 단편화가 심해져 디스크 헤더가 바쁘게 움직일 수 있습니다.

4. 하드디스크 물리적 불량 (Bad Sector)
하드디스크의 특정 섹터를 읽지 못하면, 드라이브는 해당 섹터를 다시 읽기 위해 수십 번 재시도(Retry)를 합니다. 이 과정에서 '드르륵' 소리가 반복되며 시스템 전체가 해당 I/O 처리를 기다리느라 멈추게 됩니다.

확인: [저장소 관리자] > [HDD/SSD] > [건강 상태]에서 S.M.A.R.T. 정보 및 배드 섹터 카운트를 반드시 확인하세요.

🛠️ 해결 및 예방 조치
로그 센터 상세 확인: 일반 로그에 없다면 로그 센터 > 로그 > 상단 드롭다운에서 [시스템] 외에 [드라이브] 관련 로그가 있는지 다시 한번 확인해 보세요.

리소스 모니터 설정: [리소스 모니터] > [설정]에서 '사용 내역 활성화'를 체크해 두세요. 다음에 문제가 생기면 재부팅 후 어느 시점에 디스크 점유율이나 I/O Wait이 튀었는지 그래프로 볼 수 있습니다.

메모리 업그레이드: 만약 스왑 현상이 원인이라면 RAM을 증설하는 것이 가장 확실한 해결책입니다.

불필요한 패키지 중지: 쓰지 않는 패키지(특히 인덱싱을 유발하는 미디어 관련 앱)는 중지시켜 두는 것이 좋습니다.- 인덱싱 작업은 진행된 것 같지 않았다. gitea를 커밋하며 푸시된 파일들이 그 정도로 무리가 갈 것 같지는 않았다.
- 리소스 모니터로 확인해본 결과, 프로세스에는 전혀 무리가 가는 상황은 아니었다.
- Btrfs - 현재 파일시스템 구성이었기에 의심이 되었으나, 백그라운드 작업이 갑자기 이루어지는 문제를 어떻게 점검할 지 고민이 되었기에 킵했다.
- 하드디스크 물리적 불량 - SMART 분석 결과 모두 정상임을 확인하였다.
1. 로그 센터 말고 '진짜' 로그 확인 (dmesg)
GUI가 멈출 정도였다면 커널 레벨에서 I/O 대기 시간 초과(Blocked Task)가 발생했을 가능성이 매우 높습니다. SSH 접속 후 아래 명령어를 입력하세요.

명령어: dmesg -T | grep -i "blocked" 또는 dmesg -T | tail -n 500

확인 내용: task [프로세스명] blocked for more than 120 seconds 같은 문구가 있는지 보세요. 만약 있다면, 특정 프로세스가 디스크 응답을 기다리다가 시스템 전체를 잡고 늘어진 증거입니다.

2. Btrfs의 범인: btrfs-cleaner 프로세스
Btrfs에서 가장 빈번하게 발생하는 '조용한 폭주'는 스냅샷 삭제 후 남은 데이터를 정리하는 작업입니다.

증상: CPU/RAM 사용량은 평온한데 디스크만 '드르륵'거리며 I/O Wait이 치솟음.

확인 방법: SSH에서 top을 실행한 뒤 Shift + p (CPU 순) 또는 iotop이 설치되어 있다면 디스크 쓰기 순으로 정렬해 보세요. btrfs-cleaner 혹은 btrfs-transacti가 상단에 있다면 이놈이 범인입니다.

특징: 스냅샷을 대량으로 삭제하거나, 오래된 스냅샷이 자동 삭제될 때 백그라운드에서 실행되며, 작업이 끝날 때까지 멈추지 않습니다.

3. /var/log/messages 분석
시놀로지의 모든 상세 기록은 GUI가 아니라 이 파일에 담깁니다. 재부팅 직전 상황을 보려면 다음 명령어를 쓰세요.

명령어: sudo cat /var/log/messages | grep -E "crit|err|warn"

포인트: 재부팅(강제 종료) 직전 타임스탬프에 BTRFS error, I/O error, 혹은 Out of memory (SWAP 관련) 기록이 있는지 확인하세요.
터미널로 접속하여 하나씩 확인하였다.
제미나이의 답변에서 뭔가 이상함을 감지했다.
보여주신 로그를 보니 범인이 아주 명확하게 보입니다. 범인은 도커(Docker) 컨테이너들의 동시다발적인 시동과 그 과정에서 발생하는 '권한 변경(chown/chmod)' 작업입니다.

로그의 04:36:32부터 04:37:17 사이를 보면, 짧은 시간 동안 최소 6개 이상의 도커 컨테이너가 한꺼번에 올라오고 있습니다. 특히 결정적인 증거는 이 부분입니다.

msg='op=changing home directory id=1000 exe="/usr/sbin/usermod" ... res=success'
msg='op=changing /etc/group; group abc/1000 acct="abc" exe="/usr/sbin/groupmod" ... res=success'

1. 왜 하드가 비명을 질렀나? (원인 분석)
로그에 등장하는 abc 유저와 usermod 기록은 주로 LinuxServer.io 같은 곳에서 만든 컨테이너 이미지들을 쓸 때 나타납니다. 이 컨테이너들은 시작될 때 다음과 같은 일을 합니다.

권한 맞추기 (PUID/PGID): 컨테이너 내부의 abc 사용자가 호스트(시놀로지)의 파일에 접근할 수 있도록, 연결된 볼륨(매핑된 폴더) 전체의 소유권을 강제로 변경(chown -R)하거나 확인합니다.

I/O 폭주: 만약 도커에 연결된 폴더에 파일이 수만 개, 수십만 개가 들어있다면? 컨테이너 6~7개가 동시에 수만 개의 파일 권한을 훑으며 디스크를 긁어댑니다.

Btrfs의 비명: Btrfs는 메타데이터 기록 방식 때문에 이런 자잘한 파일 권한 변경 작업이 몰리면 I/O 병목이 엄청나게 심해집니다. 하드디스크는 헤드가 미친 듯이 왔다 갔다 하며 '드르륵' 소리를 내고, 시스템은 이 I/O 처리를 기다리느라(Wait) 먹통이 된 겁니다.

2. 로그에 기록이 없었던 이유
이건 '크래시(오류)'가 아니라 시스템 입장에서는 '정상적인 작업 중'이었기 때문입니다. 다만 그 작업이 하드디스크의 한계를 넘어서서 서비스가 응답하지 못했을 뿐입니다. 강제 재부팅을 했으니 커널이 비정상 종료 로그를 남길 틈도 없었을 것입니다.
동시 다발적인 권한 변경?
그 와중에 갑자기 다시 드르륵 소리와 함께 메모리 사용량이 치솟는 것을 확인하였다!
일단, 구동 중인 Docker 컨테이너들을 점검한 결과, gitea에서 14GB나 갑자기 사용하는 것이었다 ??!
-> 깃을 사용 중인 상황이었으나 푸시하지도 않았기 때문에 너무나도 이상한 상황!
급하게 gitea 컨테이너를 중지하니 해당 현상이 사라졌다.
확실해졌다. 아.. 누군가 공격을 시도하는 구나!
실제로 gitea 컨테이너 로그를 확인하니 여러 아이피들에서 접근한 기록들을 확인할 수 있었다.
Gitea가 14GB 이상의 메모리를 잡아먹고 있다면, 이건 단순히 '바쁜' 수준이 아니라 시스템이 가동 범위를 넘어선 비상 상황입니다. Gitea는 원래 아주 가볍게 돌아가는 도구인데, 외부 IP들이 접속해서 리소스를 빨아먹고 있다면 99% 확률로 봇(Bot)에 의한 무차별 크롤링이나 취약점 스캐닝 공격입니다.

지금 겪고 계신 현상의 구체적인 분석과 차단 방법을 정리해 드립니다.

1. 외부 IP가 내 Gitea에서 뭘 하고 있는 걸까?
보통 이런 공격이나 크롤링은 다음과 같은 목적을 가집니다.

코드 탈취 및 보안 분석: 공개된 저장소(Public Repo)를 싹 긁어 가서 그 안에 담긴 API Key, 비밀번호, 설정 파일 등을 찾아냅니다.

Git 취약점 스캔: 특정 버전의 Gitea나 Git 자체의 취약점을 이용해 RCE(원격 코드 실행)를 시도하려고 계속해서 패킷을 던지는 겁니다.

인덱싱 봇: 구글이나 바이두 같은 검색 엔진 봇일 수도 있지만, 사악한 의도를 가진 커스텀 봇들은 짧은 시간에 수천 번의 GET 요청을 보내 서버를 마비시킵니다.

2. 왜 14GB나 먹고 하드가 비명을 지르나?
Gitea는 요청이 들어오면 Git 바이너리를 실행해서 파일을 읽고, 차이(Diff)를 계산하거나 아카이브를 만듭니다.

메모리 폭주: 수많은 외부 접속자가 동시에 "이 파일 보여줘", "저 커밋 내역 보여줘"라고 요청하면, Gitea는 각 요청마다 메모리를 할당하다가 결국 NAS의 18GB 중 대부분을 점유하게 됩니다.

디스크 비명: 파일의 메타데이터를 읽고 Git 오브젝트를 계산하기 위해 하드디스크의 헤더가 미친 듯이 움직이는 것입니다.

🛠️ 당장 조치해야 할 보안 가이드
지금 바로 아래 조치들을 취해서 NAS를 진정시켜야 합니다.

① Gitea를 '폐쇄형'으로 전환 (가장 중요)
누구나 내 저장소를 볼 수 있게 열려 있다면 타겟이 되기 쉽습니다. app.ini 설정을 변경하세요.

REQUIRE_SIGNIN_VIEW = true: 로그인하지 않으면 아무것도 못 보게 막습니다.

DISABLE_REGISTRATION = true: 외부인이 계정을 생성하는 것을 막습니다.

② 시놀로지 방화벽 설정 (국가별 차단)
만약 해외에서 접속할 일이 없다면, 한국 IP만 허용하고 나머지는 모두 차단하세요. 이것만 해도 공격 시도의 90% 이상이 사라집니다.

[제어판] > [보안] > [방화벽]에서 설정 가능합니다.

③ 도커 메모리 제한 (리소스 보호)
Gitea가 혼자서 14GB를 다 먹지 못하도록 물리적으로 가둬야 합니다.

도커 컨테이너 설정에서 메모리 제한을 2GB나 4GB 정도로 거세요. 그러면 Gitea가 죽을지언정 시놀로지 시스템 전체가 뻗지는 않습니다.

④ Fail2Ban 도입
특정 시간 동안 과도하게 접속을 시도하거나 실패하는 IP를 시놀로지 차원에서 차단하도록 설정하세요. (시놀로지 [제어판] > [보안] > [자동 차단] 활성화)
생각해보니 이전 시놀로지 사용 시에 설정했던 방화벽을 현재는 적용하지 않은 것을 확인했다!! 😣
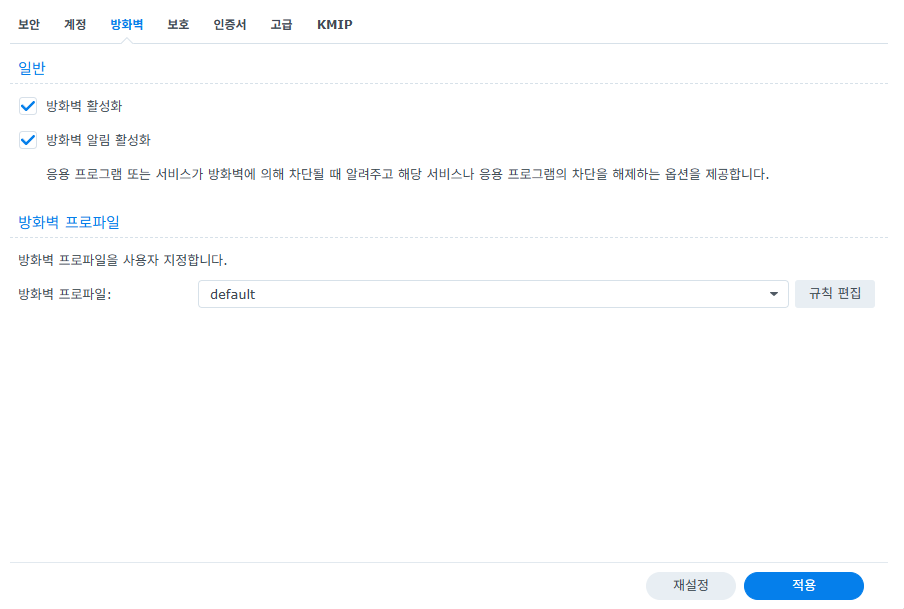
급하게 방화벽 프로파일 규칙편집을 진행했다.
1. 내부 네트워크에 대한 서브넷 허용
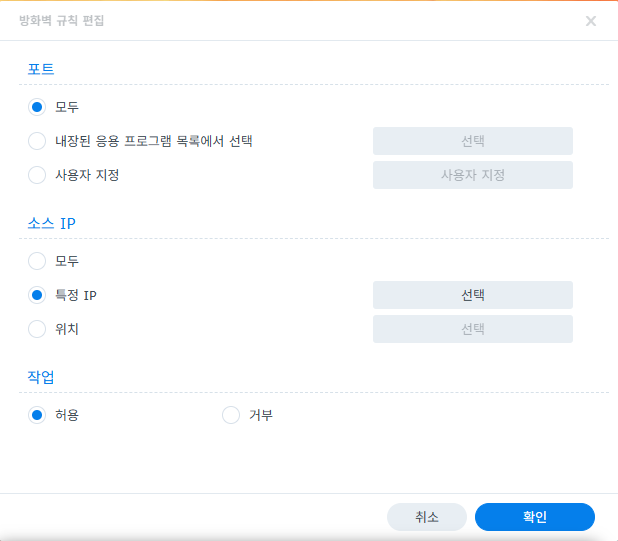
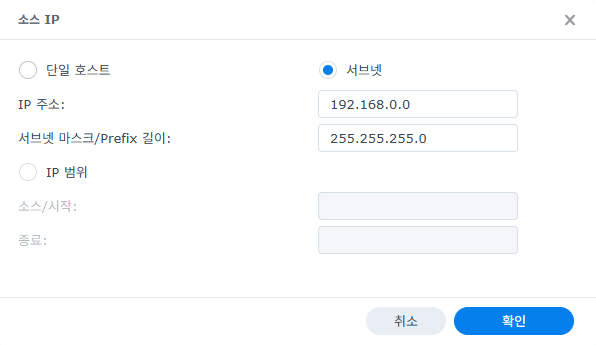
2. 국가별 아이피 허용
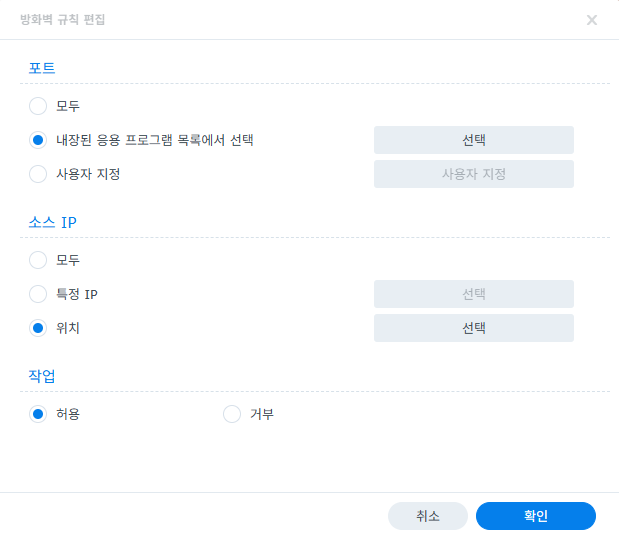
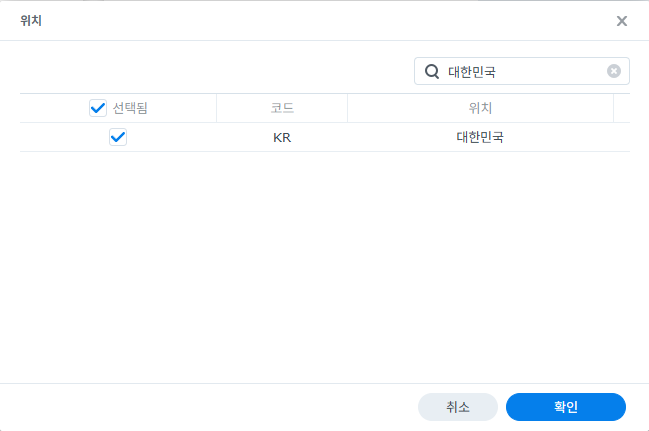
3. 나머지 모두 거부
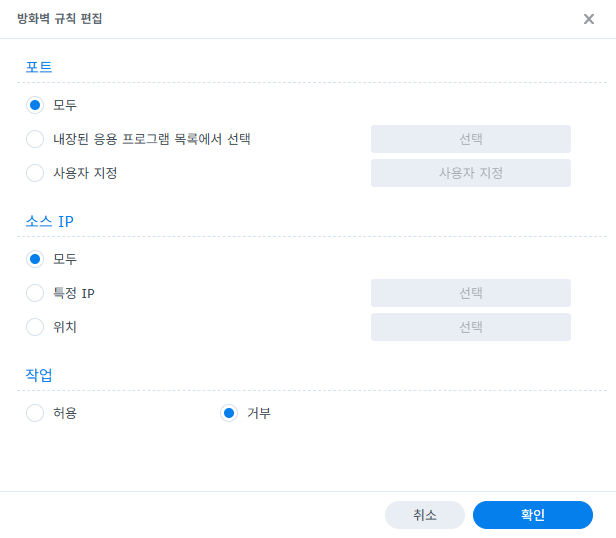
혹여나 해외출국 시에는 해당 국가를 그때 그때 추가해야겠지만,
분명 나는 까먹을 것이다...😣
비상용으로 Tailscale도 복구 시켰다.
방화벽 규칙을 적용 후, 다시 gitea 컨테이너를 실행했다.
그리고 드르륵 소리가 더 이상 나지 않는다.
메모리도 정상적으로 동작하였다.
보잘 것 없는 gitea를 털려고 하다니...
너무 위험한 세상이다... w(゚Д゚)w